注目の投稿

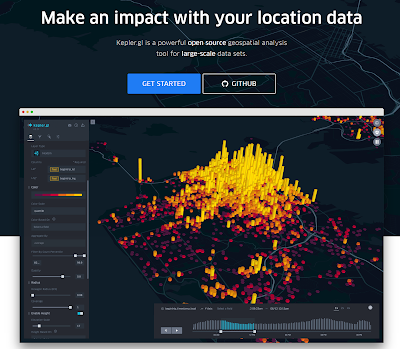
【kepler.gl】コロナ対策による人流の変化も地図上に可視化(各種メディアで報道)

kepler.glのサイト画面 kepler.glを使ってコロナ対策の効果を分析したところ、テレビ、新聞、ネットのメディアから問い合わせや報道依頼が殺到。今も、土日返上で都内や全国の人流変化を分析しています。この記事では人流変化の可視化に便利なkepler.glにつ...

ラベル R の投稿を表示しています。 すべての投稿を表示

2019年11月2日土曜日

【R】Rでfor文を書く(ループの設定)

Rでfor文

  • 目的:Rでfor文を書く
  • 方法:for関数を使う

◇書き方

#for文
for(i in 1:3){ # iを1 ~ 3まで繰り返す
}

◇実行結果

> #for文
> for(i in 1:3){ # 1 ~ 3まで繰り返す
+   print(i) # iを表示する
+ }
[1] 1
[1] 2
[1] 3
>

◇応用:for文を使ってテーブルのデータを増やす

> #xテーブルをつくる
> library(data.table)
> x <- data.table(id = 1) #library(data.table)必要
> x
   id
1:  1
>
> for(i in 2:3){ # 2 ~ 3まで繰り返す
+   y <- data.table(id = i) #id列にiが入るyテーブルを創る
+   x <- rbind(x, y) #xテーブルにyテーブルを連結する
+ }
> x
   id
1:  1
2:  2
3:  3
>

for文を擬人化してみた


2019年7月12日金曜日

R 任意の行でデータを分割

【目的】 任意の行でデータを分割する
【方法】 データ名[最初の行:最後の行]

#テスト用データを作成

library(data.table)  #データテーブル作成のために読み込む

> data <- data.table(No = 1:10,random = runif(10, min = 0, max = 1))
> data
    No      random
 1:  1 0.301603490
 2:  2 0.745845367
 3:  3 0.559383677
 4:  4 0.737294025
 5:  5 0.525487942
 6:  6 0.361071876
 7:  7 0.259251202
 8:  8 0.002998326
 9:  9 0.909486709
10: 10 0.895856187
> 

*runifで0~1までの実数をランダムに生成

#3行目までを分割する

> data_a <- data[1:3]
> data_a
   No    random
1:  1 0.3016035
2:  2 0.7458454
3:  3 0.5593837
> 

あれ、randomの値が四捨五入されてる??

#dataを半分に分割する

*lengthでベクトルの長さが分かるのでそれを2で割れば半分に分割できる

> data_1 <- data[1:(length(data$random)/2)]
> data_2 <- data[(length(data$random)/2+1):(length(data$random))]
> data_1
   No    random
1:  1 0.3016035
2:  2 0.7458454
3:  3 0.5593837
4:  4 0.7372940
5:  5 0.5254879
> data_2
   No      random
1:  6 0.361071876
2:  7 0.259251202
3:  8 0.002998326
4:  9 0.909486709
5: 10 0.895856187
>

data_1は四捨五入されてるけど、data_2は元の値だ。なぜ??

2017年8月13日日曜日

R dplyrとはなんぞや?大規模データも簡単に処理? ~使い方~

前回のおさらい

dplyrとは?
  1. Rで大規模データをさくさく処理するためのパッケージ
  2. 内部結合とかSQLみたいな処理もできる
  3. Rでデータ処理する人は必ず使ってる(くらいメジャーで有用)

導入は簡単!

インストールして
> install.packages("dplyr")
 

パッケージを読み込むだけ
> library(dplyr)

今回は使い方を説明

前回はRのサンプルデータを使ったせいで妙なエラーに悩まされました。なので、オリジナルのサンプルデータを作成していろいろ使い方を紹介していきます。

実はRで遭遇するエラーの多くがデータの構造や型に起因するものです。データがしっかりしていれば、大抵うまくいきます。そのため、データのところは丁寧めに説明しています。

「ちゃんとした」サンプルデータをつくろう

と、言うわけでサンプルデータの作成からはじめていきます。

そのサンプルデータですが、データフレームの構造にする必要があります。なぜなら、dplyrはデータフレームでないと使えないためです。

ちなみに、dplyrは普通のデータフレーム(data.frame)でも利用できますが、dplyr用に最適化されたデーターフレーム(tbl_df)もあります。

違いは、普通のdata.frameでデータ名を実行するとコンソールに全データが表示されますが、tbl_dfだと勝手に要約して表示されます。

(え、それだけ!?)

たぶん他にも違いはあると思うので気になる方はぐぐってください!

では、データをつくります。

> #サンプルデータ作成
> 
> #まずはベクトルデータをつくる(先頭のv.はベクトルだと分かりやすいように付けているだけです)
> v.date <- c("2017-08-01","2017-08-02","2017-08-03","2017-08-04","2017-08-05")
> v.sales <- c(100,200,300,40,500)
> 
> #データフレームを作成
> df.data <- tbl_df(date = v.date, sales = v.sales)
Error in tbl_df(date = v.date, sales = v.sales) : 
  unused arguments (date = v.date, sales = v.sales)

 あ、やっぱりエラー出た。tbl_dfではデータをつくれないか。まずは、data.frame()でデータをつくる必要があるようですね。

気を取り直して、

> #データフレームを作成
> df.data <- data.frame(date = v.date, sales = v.sales)
> class(df.data) #データ構造の確認
[1] "data.frame"

無事にエラーなくデータフレームできました。classという関数でデータ構造を確認すると、ちゃんとdata.frameになってますね。

では、データを表示してみましょう。

> #データ表示
> df.data
        date sales
1 2017-08-01   100
2 2017-08-02   200
3 2017-08-03   300
4 2017-08-04    40
5 2017-08-05   500

今回はデータ少ないので特に問題ないですが、もし、100万行くらいのデータの場合はコンソールがデータでいっぱいになります。

では、data.frameをtbl_dfに変換します。

> #tbl_dfに変換
> df.data <- tbl_df(df.data)
> class(df.data) #データ構造の確認
[1] "tbl_df"     "tbl"        "data.frame"

tbl_dfが表示されています。うまく変換できているようです。

では、データを表示してみましょう。

> #データ表示
> df.data
# A tibble: 5 x 2
        date sales
      <fctr> <dbl>
1 2017-08-01   100
2 2017-08-02   200
3 2017-08-03   300
4 2017-08-04    40
5 2017-08-05   500

data.frameの時と少し違いますね。

# A tibble: 5 x 2
は、データが5行で2列のデータであることを示します。

カラム名の下にある<fctr>と<dbl>ですが、それぞれデータの性質を意味しており、簡単に言うと、

<fctr>は文字!
<dbl>は数値!

です(正確にはちょっと違いますが)。

第三者> あれれー? dateって日付なのに文字になってるー!

はい。

このままだと、dateを日付として扱うことができません。

そこで、日付に変換します。

> #dateを日付データに変換
> df.data$date <- as.Date(df.data$date)
> 
> #データ表示
> df.data
# A tibble: 5 x 2
        date sales
      <date> <dbl>
1 2017-08-01   100
2 2017-08-02   200
3 2017-08-03   300
4 2017-08-04    40
5 2017-08-05   500

dateの下が<date>となり日付として認識されました。(日付と認識されることで、日付の計算や不等号を用いての条件検索ができるようになります。)

やっぱり、tbl_df便利ですね!
データ名で実行しただけで、データ型も表示してくれます。

これでサンプルデータ作成は終わりです。


dplyrを使ってみよう

 一気にいきましょう。簡単です!

  1. 行指定の条件抽出:filter
  2. 列指定の条件抽出:select
  3. 並び変える:arrange
  4. 新しい列の作成:mutate
  5. 複数の処理をつなげる:%>%
  6. まとめて:group_by、計算する:summarise
  7. 結合処理もできる:inner_joinなど

1.行指定の条件抽出:filter

2017年8月3日以降のデータを抽出するには、

> #filter
> filter(df.data, date > "2017-08-03")
# A tibble: 2 x 2
        date sales
      <date> <dbl>
1 2017-08-04    40
2 2017-08-05   500

これでOK!

もし、dateをdate型に変換せずに<fctr>のままだと、

> #filter
> filter(df.data, date > "2017-08-03")
# A tibble: 0 x 2
# ... with 2 variables: date <fctr>, sales <dbl>
Warning message:
In Ops.factor(date, "2017-08-03") : ‘>’ not meaningful for factors

このようにエラーとなります。

2.列指定の条件抽出:select

 salesの列だけ抽出するのは、

> #select
> select(df.data, sales)
# A tibble: 5 x 1
  sales
  <dbl>
1   100
2   200
3   300
4    40
5   500

これでOK!ベリーイージー!

3.並び変える:arrange

salesの昇順で並べるには、

> arrange(df.data, sales)
# A tibble: 5 x 2
        date sales
      <date> <dbl>
1 2017-08-04    40
2 2017-08-01   100
3 2017-08-02   200
4 2017-08-03   300
5 2017-08-05   500

はい、OK!

ちなみに降順は、

> #arrange
> arrange(df.data, desc(sales))
# A tibble: 5 x 2
        date sales
      <date> <dbl>
1 2017-08-05   500
2 2017-08-03   300
3 2017-08-02   200
4 2017-08-01   100
5 2017-08-04    40

desc(カラム名)でOK!

そう言えば昔、記事書いていました。
R 順番を変える(arrange)

4.新しい列の作成:mutate

日付の年だけ取り出した新しい列をつくるには、

> #mutate
> mutate(df.data, year = substring(date,1,4))
# A tibble: 5 x 3
        date sales  year
      <date> <dbl> <chr>
1 2017-08-01   100  2017
2 2017-08-02   200  2017
3 2017-08-03   300  2017
4 2017-08-04    40  2017
5 2017-08-05   500  2017

これでOK!!

今回はsubstringという関数も使っています。

substringの使い方は、
substring(カラム名、切り出す最初の文字の順番、切り出す最後の文字の順番)
です。

こちらも昔、記事書いていたのでご参考まで
【R】 日付データから年や月だけを抜き出す方法

5.複数の処理をつなげる:%>%

複数の処理をつなげて一緒にするには、

> df.data %>%
+ filter(date > "2017-08-03") %>%
+ select(sales) %>%
+ arrange(desc(sales))
# A tibble: 2 x 1
  sales
  <dbl>
1   500
2    40

 これでOK!

6.まとめて:group_by、計算する:summarise

年でまとめてsalesの合計を計算するには、

> #group_by summarise
> df.data %>%
+   mutate(year = substring(date,1,4)) %>%
+   group_by(year) %>%
+   summarise(total = sum(sales))
# A tibble: 1 x 2
   year total
  <chr> <dbl>
1  2017  1140

これでオッケーです!

7.結合処理もできる:inner_joinなど

実は、SQLでお馴染みの内部結合とかもできます!

結合処理にはもう一つデータが必要なのでパパっと作成しましょう。

> #まずはベクトルを作成
> v.date <- c("2017-08-01","2017-08-02","2017-08-03","2017-08-04","2017-08-05")
> v.user <- c(1000,20,300,4,50)
> 
> #データフレームを作成
> df.data_2 <- data.frame(date = v.date, user = v.user)
> class(df.data_2) #データ構造の確認
[1] "data.frame"
> #tbl_dfに変換
> df.data_2 <- tbl_df(df.data_2)
> class(df.data_2) #データ構造の確認
[1] "tbl_df"     "tbl"        "data.frame"

はい。2つ目のデータ完成しました。

では、最初のデータを新たに作ったデータを確認しましょう。

> #data
> df.data
# A tibble: 5 x 2
        date sales
      <date> <dbl>
1 2017-08-01   100
2 2017-08-02   200
3 2017-08-03   300
4 2017-08-04    40
5 2017-08-05   500
> df.data_2
# A tibble: 5 x 2
        date  user
      <fctr> <dbl>
1 2017-08-01  1000
2 2017-08-02    20
3 2017-08-03   300
4 2017-08-04     4
5 2017-08-05    50

おっと、df.data_2のdateが<fctr>になってる。

df.data_2のdateを日付に変換するのを忘れてましたね。

変換しましょう。

> #日付に変換
> df.data_2$date <- as.Date(df.data_2$date)
> 
> #data
> df.data
# A tibble: 5 x 2
        date sales
      <date> <dbl>
1 2017-08-01   100
2 2017-08-02   200
3 2017-08-03   300
4 2017-08-04    40
5 2017-08-05   500
> df.data_2
# A tibble: 5 x 2
        date  user
      <date> <dbl>
1 2017-08-01  1000
2 2017-08-02    20
3 2017-08-03   300
4 2017-08-04     4
5 2017-08-05    50

これで準備OK。

やっぱり、tbl_dfだとすぐにデータ型を確認できるのでいいですね。

さて、2つのデータが揃ったので内部結合してみましょう。両データに共通するカラムはdateなので、dateをキーにして2つのデータを結合すると、

> #inner_join
> inner_join(df.data, df.data_2, by = "date")
# A tibble: 5 x 3
        date sales  user
      <date> <dbl> <dbl>
1 2017-08-01   100  1000
2 2017-08-02   200    20
3 2017-08-03   300   300
4 2017-08-04    40     4
5 2017-08-05   500    50

こうなります。

他にも外部結合とかアンチ結合とかもできるので下記の記事をご参照ください。

---他の結合---
R 内部結合(inner join)
R 内部結合(複数key)
R 外部結合(left join, right join)
R 完全外部結合(full join)
R アンチ結合(anti join)


以上でdplyrの使い方は終わりです。

本当はまだまだ奥が深く1%も説明できてないですが、以上のことだけでも実用には十分だと思います。

次回は、tidyrという大規模データのクロス集計等を高速におこなうパッケージについて説明できればと思っています。

それでは、

一度は富士山に登ってみたい


2017年8月11日金曜日

R dplyrとはなんぞや?大規模データも簡単に処理? ~導入編~

dplyrとは

  1. Rで大規模データをさくさく処理するためのパッケージ
  2. 内部結合とかSQLみたいな処理もできる
  3. Rでデータ処理する人は必ず使ってる(くらいメジャーで有用)
以上!!

あとはだらだら使い方を説明。

使い方

まず、データを用意する。

用意するデータは、ドイツなどの株価指数のデータ。

(全然大規模データじゃないけど。。)

> #Rに最初からあるサンプルデータ(EuStockMarkets)を使う
> #中身は主要株価指数:DAX(ドイツ)、SMI(スイス)、CAC(フランス)、FTSE(イギリス)
> #データの先頭部分を確認してみる
> head(EuStockMarkets)
         DAX    SMI    CAC   FTSE
[1,] 1628.75 1678.1 1772.8 2443.6
[2,] 1613.63 1688.5 1750.5 2460.2
[3,] 1606.51 1678.6 1718.0 2448.2
[4,] 1621.04 1684.1 1708.1 2470.4
[5,] 1618.16 1686.6 1723.1 2484.7
[6,] 1610.61 1671.6 1714.3 2466.8
> #作図
> plot(EuStockMarkets)

plot(EuStockMarkets)の結果。上からドイツ、スイス、フランス、イギリスの主要株価指数の日次データ

グラフにすると分かりやすい♪

*このデータを使ったせいで後ほど不思議なエラーに遭遇します

準備①:dplyrをインストールする

下記のコードを実行。

> install.packages("dplyr")

これを実行すると、勝手にダウンロード・インストールが始まる。

インストールできたらdplyrを読み込む。

> library(dplyr)


準備②:データをtbl_dfというデータ構造に変換

(まあ、普通のデータフレーム:data.frameでも操作可能だけど。。)

ちなみに、dplyrを読み込まないと、、

> #tbl_df(データフレーム拡張したデータ構造)に変換
> EuStockMarkets_df <- tbl_df(EuStockMarkets)
Error in tbl_df(EuStockMarkets) : could not find function "tbl_df"

あ、エラーだ。
肝心のdplyr読み込むの忘れるとエラーになります。。

ちゃんと、dplyrを読み込むと、

> library(dplyr)

 次のパッケージを付け加えます: ‘dplyr’ 

 以下のオブジェクトは ‘package:data.table’ からマスクされています: 

     between, first, last 

 以下のオブジェクトは ‘package:stats’ からマスクされています: 

     filter, lag 

 以下のオブジェクトは ‘package:base’ からマスクされています: 

     intersect, setdiff, setequal, union 

> #tbl_df(データフレーム拡張したデータ構造)に変換
> EuStockMarkets_df <- tbl_df(EuStockMarkets)

エラーでません。

ちなみに、tbl_dfに変換しておくと、データ名実行でデータの要約が表示されます。

> EuStockMarkets_df
# A tibble: 1,860 x 4
       DAX    SMI    CAC   FTSE
     <dbl>  <dbl>  <dbl>  <dbl>
 1 1628.75 1678.1 1772.8 2443.6
 2 1613.63 1688.5 1750.5 2460.2
 3 1606.51 1678.6 1718.0 2448.2
 4 1621.04 1684.1 1708.1 2470.4
 5 1618.16 1686.6 1723.1 2484.7
 6 1610.61 1671.6 1714.3 2466.8
 7 1630.75 1682.9 1734.5 2487.9
 8 1640.17 1703.6 1757.4 2508.4
 9 1635.47 1697.5 1754.0 2510.5
10 1645.89 1716.3 1754.3 2497.4
# ... with 1,850 more rows

また、普通のデータフレームに変換して実行すると、

> data.frame(EuStockMarkets_df)

全データがコンソールに表示されます。
(今回は省いていますがコンソール画面はデータでいっぱいです)

あと、データ構造(クラス)を確認すると、

> class(EuStockMarkets_df)
[1] "tbl_df"     "tbl"        "data.frame"

ちゃんとtbl_dfになっています。
(data.frameも表示されているので普通のデータフレーム型としても扱えそうです)


使い方①:filterでほしい行のデータを抽出

方法は、filter(データ名, 条件)という感じ。

やってみると、

> filter(EuStockMarkets_df,  DAX <= 1450)
Error in filter_impl(.data, quo) : matrix as column is not supported

ん、エラーだ。。

意味はmatrixはサポートしてないよーて感じかな。
いやでもtbl_dfに変換しているからmatrixになってないはず。
一応、調べると、

> class(EuStockMarkets_df)
[1] "tbl_df"     "tbl"        "data.frame"

やっぱりmatrixになってない。おかしいなー。

元のサンプルデータは、、、

> class(EuStockMarkets)
[1] "mts"    "ts"     "matrix"

matrixだ。でも、変換してるから関係ないはず。。

んー、なぞだ。これバグでは??

元のサンプルデータがmatrixだから変な挙動してるのかな。

一回、データを書き出して新しいデータとして読み込んで実行してみるか。

> #write.csvでcsvファイルを書き出す *row.names = Fは行番号を書き出さない処理
> write.csv(EuStockMarkets,"C:/Users/mtsuj/data.csv",row.names = F)

> #freadはcsvを高速で読み込む関数
> #*data.tableをインストールしてlibrary(data.table)で読み込む必要
> EuStockMarkets_df <- fread("C:/Users/mtsuj/data.csv") 

> #freadで読み込むとdata.tableとdata.frameのデータ構造になる
> class(EuStockMarkets_df)
[1] "data.table" "data.frame"
> 
> #今のデータ構造でも問題ないが、今回はtbl_dfに変換する
> EuStockMarkets_df <- tbl_df(EuStockMarkets_df)
> class(EuStockMarkets_df)
[1] "tbl_df"     "tbl"        "data.frame"
> 
> #filterでドイツの株価指数が1450以下のものを抽出
> filter(EuStockMarkets_df,  DAX <= 1450)
# A tibble: 6 x 4
      DAX    SMI    CAC   FTSE
    <dbl>  <dbl>  <dbl>  <dbl>
1 1402.34 1788.0 1611.0 2446.3
2 1421.49 1820.5 1612.5 2488.4
3 1434.61 1858.2 1654.2 2517.1
4 1446.32 1870.3 1673.9 2538.8
5 1437.65 1878.4 1657.3 2541.2
6 1441.57 1881.5 1655.1 2557.2

お、いけた。

Rってこうゆうところありますよね。。

他の使い方は次回ご紹介

*使い方編はこちら
R dplyrとはなんぞや?大規模データも簡単に処理? ~使い方~

2017年7月22日土曜日

R 数字の桁数増やしてもメモリ増えないぞ!? object.sizeで実験してみた

object.sizeを使うと、ベクトルやデータフレームなどのオブジェクトのメモリ使用量を確認することができるのだが。。試しに、ちょっと実験してみたら不思議なことが起こった。

まず、サンプルのベクトルとデータフレームを用意する。

> v.x <- c(1,2,3)
> v.x1 <- c("a","b","c")
>
> v.y <- c(1,2,30)
> v.y1 <- c("A","B","C")
>
> df.x <- data.frame(id = v.x, name = v.x1)
> df.y <- data.frame(id = v.y, name = v.y1)

object.sizeでメモリ使用量を調べる。

> object.size(v.x)
72 bytes
> object.size(v.x1)
216 bytes
> object.size(df.x)
1360 bytes
> object.size(v.y)
72 bytes
> object.size(v.y1)
216 bytes
> object.size(df.y)
1360 bytes
>

ふむふむ。なるほどー。

やっぱり、数字(v.x)よりも文字列(v.x1)の方がメモリ食ってるな。

てか、72 bytes(v.x)のベクトルと216(v.x1)のベクトルでデータフレーム(df.x)を作ると、メモリが1360 bytesに跳ね上がるのかー

v.x1とv.y1の結果を見ると、小文字と大文字でメモリ使用量に変化はなさそう。

あと、v.xとv.yもメモリ使用量が変わっていないので、数字が一桁から二桁に増えたのが混ざってもあまり影響はないのかー。ちょっと、桁数をすごい増やしてみるか。

> v.z <- c(1,2,3000000000000000000000000000)
> object.size(v.z)
72 bytes

あれ??桁数すごい増やしたけど全然メモリ増えない!マジで!

なんでだろ??


R 関数の前に「?」を付けるとヘルプが表示される!

Rって関数の前に「?」を付けるとヘルプ表示されんだ!っと今さらながら気づく

例えば、

>  ?sum

とすると、ブラウザが起動してヘルプが表示される。
RStudioを使っている場合は、下記のようになる。

RStudioを使っていれば横のところに表示される

とても便利!!

他もやってみよ。

>  ?write.csv
>

(↓ヘルプから抜粋)

Data Output

Description

write.table prints its required argument x (after converting it to a data frame if it is not one nor a matrix) to a file or connection.

Usage

write.table(x, file = "", append = FALSE, quote = TRUE, sep = " ",
            eol = "\n", na = "NA", dec = ".", row.names = TRUE,
            col.names = TRUE, qmethod = c("escape", "double"),
            fileEncoding = "")

write.csv(...)
write.csv2(...)

おお!便利だ!

group_byも調べてみよー

>  ?group_by
No documentation for ‘group_by’ in specified packages and libraries:
you could try ‘??group_by’
>

なるほど。パッケージ読み込まないとやっぱりだめか。。

対象の関数(group_byなど)を使えるようにするためのパッケージ(dplyrなど)を読み込めばヘルプを表示できる

dplyrを読み込めばヘルプ表示できた!

今度から「?」使ってみよー


2017年7月19日水曜日

R "rbindlist(l, use.names, fill, idcol) でエラー: "の解決法

もし、rbindを実行し下記のエラーとなったら(rbindとは)、

>  dt.log <- dt.log="" dt.log_2="" rbind="" span=""> 
 Show Traceback

 Rerun with Debug
 rbindlist(l, use.names, fill, idcol) でエラー:
  Class attributes at column 10 of input list at position 2 does not match with column 10 of input list at position 1. Coercion of objects of class 'factor' alone is handled internally by rbind/rbindlist at the moment.


↓連結したいデータをdata.frameで読み込むと解決

>  dt.log <- data.frame="" dt.log="" dt.log_2="" rbind="">


今回のエラーは、連結したいデータがdata.tableでデータ量が多い(100万レコード以上くらい)ときに起きがち


2017年7月3日月曜日

R write関数で何ができたっけ?

Rでファイルを出力する際、「あれ、行番号を削除する命令なんだっけ?」とか、「引用符(”:ダブルクオーテーションマーク)を外すのはどうするんだっけ?」とかついど忘れしがち。

そんなときは、Rのマニュアルを見てみよう!
なるほど、行番号はrow.names、引用符はquoteだな。ふむふむ。。

write.table(x, file = "", append = FALSE, quote = TRUE, sep = " ",
            eol = "\n", na = "NA", dec = ".", row.names = TRUE,
            col.names = TRUE, qmethod = c("escape", "double"),
            fileEncoding = "")

write.csv(...)
write.csv2(...)

詳細は参考サイトにて

参考サイト


2017年6月24日土曜日

【R】 ‘Rcpp’ という名前のパッケージはありません

新しいPCを購入し、早速、RとRStudioをインストール。

dplyrをインストールして、いろいろ分析しようと思ったら、

  • ‘Rcpp’ という名前のパッケージはありません

というエラー!あれっ?

結局、McAfeeを停止したら解決。

マカフィー。。。

ちなみに、マカフィーの停止方法は、
富士通のQAがわかりやすい。


2017年6月10日土曜日

【R】日付から曜日を簡単に取得する方法

議員会館内(本文に関係なし)

◇あらすじ

久しぶりの投稿。転職後、仕事が忙しすぎて趣味で分析する気が全くわかず、完全にブログを放置。しかし、最近、仕事で売り上げの予測モデルを構築することがあり、これが(不確定要素や未知の変数が多そうな割に)結構良い感じの精度だった。それが契機となり、(学生の頃、半年後の為替を予測するコンテストで全国2位になった経験を活かしつつ?)株価の予測モデルを考えてみたくなってきた。ただ、モデル構築にはデータが必要。説明変数もなるべく多くあった方が良い。幸い日時の株価のデータはググれば簡単に手に入る。しかし、当然ながら欲しいデータがない場合もある。例えば、曜日とか(株価予測にどれくらい影響あるかはまだ調べてないけど)。。ただ、曜日についは日付データがあればRで簡単に取得できることが分かったので、その方法をご紹介。

◇ここから本題

目的:日付から曜日を取得
方法:weekdays(dt.data$time)
補足:株価データの取得先(http://k-db.com/stocks/)

・方法

> #データを読み込む
> dt.data <- read.csv(file("stocks_8411-T_1d_2017.csv",encoding = 'cp932'))
>
> #一部データの表示(こんなデータ)
> head(dt.data)
        日付  始値  高値  安値  終値    出来高    売買代金
1 2017-06-09 198.9 200.4 198.1 199.7 156941400 31296039870
2 2017-06-08 198.3 200.5 197.2 197.4 173075000 34342113170
3 2017-06-07 196.0 197.7 195.2 197.0 105695500 20771395690
4 2017-06-06 197.0 198.6 196.3 196.7  99978900 19742685840
5 2017-06-05 197.6 197.9 196.4 197.0 106257500 20945506730
6 2017-06-02 195.1 200.9 195.0 200.1 175604300 34933279840
>
> #日付をオブジェクト化しないとエラーが出る
> weekdays(dt.data$日付)
 UseMethod("weekdays") でエラー:
   'weekdays' をクラス "factor" のオブジェクトに適用できるようなメソッドがありません
>
> #日付をas.POSIXltでオブジェクト化(as.DATEでも良い)
> dt.data$time <- as.POSIXlt(dt.data$日付, format="%Y-%m-%d")
>
> #曜日を取得
> dt.data$weekdays <- weekdays(dt.data$time)
>
> #結果
> head(dt.data)
        日付  始値  高値  安値  終値    出来高    売買代金       time weekdays
1 2017-06-09 198.9 200.4 198.1 199.7 156941400 31296039870 2017-06-09   金曜日
2 2017-06-08 198.3 200.5 197.2 197.4 173075000 34342113170 2017-06-08   木曜日
3 2017-06-07 196.0 197.7 195.2 197.0 105695500 20771395690 2017-06-07   水曜日
4 2017-06-06 197.0 198.6 196.3 196.7  99978900 19742685840 2017-06-06   火曜日
5 2017-06-05 197.6 197.9 196.4 197.0 106257500 20945506730 2017-06-05   月曜日
6 2017-06-02 195.1 200.9 195.0 200.1 175604300 34933279840 2017-06-02   金曜日
>

◇その他:日付関連の投稿


つぶやき
メモリ32GB以上のノートPCほしいなー。重さ800g以下で。。


2017年3月15日水曜日

【R:自分用】クロス集計、ロジスティック、決定木、コレスポンデンス

#ライブラリを読み込む
library(dplyr)
library(data.table)
library(tidyr)
#
library(rpart) #決定木用
library(rpart.plot) #決定木用
library(partykit) #決定木作図用
#
library(MASS) #コレスポンデンス分析用
library(factoextra) #作図用

#cross集計
dt.cross <- dt.log %>%
  group_by(user_id,name) %>%
  summarise(n=max(value)) %>%
  spread(name,n)
dt.cross[is.na(dt.cross)] <- 0 #NAを0にする

#上記クロス集計に目的変数をjoin
dt.buy_next <- dt.log_next %>%
  group_by(user_id) %>%
  summarise(count = length(user_id))
dt.for_model <- left_join(dt.cross, dt.buy_next, by = "user_id")
dt.for_model$user_id <- NULL
dt.for_model[is.na(dt.for_logit)] <- 0 #NAを0にする

#ロジスティック分析
result <- glm(count ~ .,data = dt.for_model)
summary(result)

#出力
write.csv(summary(result)$coefficients[,"Estimate"],
          "C:/logit_Estimate.csv")
write.csv(summary(result)$coefficients[,"Pr(>|t|)"],
          "C:/logit_Pvalue.csv")

#---
#決定木
#method = "class" yが質的変数 cpは破線と交わる値が理想だが目的に合わせて適時設定
result.tree <- rpart(count ~., data = dt.cross_model, method = "class",cp = 0.002)
print(result.tree)
#検証
printcp(result.tree)
plotcp(result.tree)
#
#作図
plot(as.party(result.tree))


#---
#コレスポンデンス分析
#nfは軸を意味する
result.1 <- corresp(tmp, nf=3)
#
#write results:任意の場所に書き出す
write.csv(result.1$rs,
          "C:/result_1_rs.csv")
write.csv(result.1$cs,
          "C:/result_1_cs.csv")
#
#作図
#一般的な図
#biplot(result.1, xlim = c(-0.8, 0.8), ylim = c(-0.6, 0.6))
#少し見栄えの良い図
fviz_ca_biplot(result.1) + theme_minimal(base_size = 12)
#
#寄与率
result.1.koyuti <- result.1$cor^2
sum(result.1.koyuti)
kiyoritu <- 100*result.1.koyuti / sum(result.1.koyuti)
kiyoritu

2017年3月8日水曜日

【R:最速入門】インストールから外部結合までを30分以内で!?

RStudioで外部結合のコードを実行したときの画面。エディタのデザインはオプションで自由に変えられる。下記の順序で進めれば、Rが初めてでもインストールから外部結合をできる環境を構築するまで30分もかからずにできる(と思います)。

◇ちょっと背景

愛用のMacBook Airが壊れてしまい、新たにWindows PC(MB-B502E)を購入。価格は約4万円と安いが、少々もっさり。。でも、ボーナスまでこれで耐え忍ぶしかない!

◇ということで、新しいPCに「R」をインストール!

  • まずはRのサイトにいく(Rのサイト:OS選択画面)
  • Download R for Windowsをクリック
    OS選択画面:Windowsをクリックする
  • base 又は install R for the first timeをクリック
    独自のRを構築したい人以外はbaseでOK
  • Download R 3.3.3 for Windowsをクリック
    バージョンは2017/03/08時点のもの
  • ファイルをダウンロードして実行すると、言語の選択を求められる。今回は日本語で
    日本語を選択
  • 次へをクリック
    インストールの開始
  • 説明を読んで次へをクリック
    読んだことない。。
  • 次へをクリック
    インストール先を変更したい方はどうぞ
  • 次へをクリック
    OSが64bitの方は32bitいらないかも
  • 次へをクリック
    デフォルトで問題なし
  • 次へをクリック
    そのままでOK
  • 次へをクリック
    ただ、R Studio使うのでデスクトップにアイコン無くてもOK
  • インストールされます
    インストール中
  • Rのインストールは完了です
    完了画面
  • Rを起動。一応、これでも使えるが、コンソールからコードを書くのは大変面倒で作業効率が極めて悪い。そのため、R Studioをインストール。
    これでも使えるが作業効率悪い
  • R Studioのサイトにいく(R StudioのHP)
  • Download RStudioをクリック
    下の方にもダウンロードのリンクがある
  • 一番左の「RStudio Desktop Open Source License」をダウンロード
    バージョン選択画面
  • 「RStudio 1.0.136 - Windows Vista/7/8/10」をクリック
    クリック後、ファイルがダウンロードされる
  • 次へをクリック
    ダウンロードしたファイル実行するとセットアップがはじまる
  • 次へをクリック
    必要に応じてインストールフォルダを変更できる
  • インストールをクリック
    ショートカットを作成しないこともできる
  • 完了をクリック
    これで終わり
  • RStudioを起動するとこんな感じ
    コンソール画面が出てくるがここにコードは基本書かない
  • 左上のFileからNew Fileを選択してR Scriptを開く
    このR Scriptで作成したファイルにコードを書いていく
  • 実際にコードを書いてみた様子
    Rで外部結合をするためのコード
  • 実際のコード

#Rで外部結合するには?left joinとright joinを

#パッケージインストール
install.packages("data.table")
install.packages("dplyr")

#インストールしたパッケージを使う
library(data.table)
library(dplyr)

#サンプルデータを作成
v.x <- c(1,2,3)
v.x1 <- c("a","b","c")
v.y <- c(1,2,30)
v.y1 <- c("A","B","C")
#データフレーム型にする(外部結合するため)
df.x <- data.frame(id = v.x, name = v.x1)
df.y <- data.frame(id = v.y, name = v.y1)

#データを表示
df.x
df.y

# left join
left_join(df.x, df.y, by = "id")

# right join
right_join(df.x, df.y, by = "id")


  • 全てのコードを選択してRunをクリック(Sourceでも全コードを実行できるが、実際の作業では部分的に実行する事が多くほとんどRunしか使わない。そのため、ここでもRunを用いた)
  • 実行結果
> #Rで外部結合するには?left joinとright joinを
> 
> #パッケージインストール
> install.packages("data.table")
Installing package into ‘C:/Users/mtsuj/OneDrive/Documents/R/win-library/3.3’
(as ‘lib’ is unspecified)
trying URL 'https://cran.rstudio.com/bin/windows/contrib/3.3/data.table_1.10.4.zip'
Content type 'application/zip' length 1502201 bytes (1.4 MB)
downloaded 1.4 MB

package ‘data.table’ successfully unpacked and MD5 sums checked

The downloaded binary packages are in
C:\Users\mtsuj\AppData\Local\Temp\RtmpKsWlwv\downloaded_packages
> install.packages("dplyr")
Installing package into ‘C:/Users/mtsuj/OneDrive/Documents/R/win-library/3.3’
(as ‘lib’ is unspecified)
trying URL 'https://cran.rstudio.com/bin/windows/contrib/3.3/dplyr_0.5.0.zip'
Content type 'application/zip' length 2557605 bytes (2.4 MB)
downloaded 2.4 MB

package ‘dplyr’ successfully unpacked and MD5 sums checked

The downloaded binary packages are in
C:\Users\mtsuj\AppData\Local\Temp\RtmpKsWlwv\downloaded_packages
> 
> #インストールしたパッケージを使う
> library(data.table)
data.table 1.10.4
  The fastest way to learn (by data.table authors): https://www.datacamp.com/courses/data-analysis-the-data-table-way
  Documentation: ?data.table, example(data.table) and browseVignettes("data.table")
  Release notes, videos and slides: http://r-datatable.com
> library(dplyr)
-----------------------------------------------------------------------------------
data.table + dplyr code now lives in dtplyr.
Please library(dtplyr)!
-----------------------------------------------------------------------------------

 次のパッケージを付け加えます: ‘dplyr’ 

 以下のオブジェクトは ‘package:data.table’ からマスクされています: 

     between, first, last 

 以下のオブジェクトは ‘package:stats’ からマスクされています: 

     filter, lag 

 以下のオブジェクトは ‘package:base’ からマスクされています: 

     intersect, setdiff, setequal, union 

> 
> #サンプルデータを作成
> v.x <- c(1,2,3)
> v.x1 <- c("a","b","c")
> v.y <- c(1,2,30)
> v.y1 <- c("A","B","C")
> #データフレーム型にする(外部結合するため)
> df.x <- data.frame(id = v.x, name = v.x1)
> df.y <- data.frame(id = v.y, name = v.y1)
> 
> #データを表示
> df.x
  id name
1  1    a
2  2    b
3  3    c
> df.y
  id name
1  1    A
2  2    B
3 30    C
> 
> # left join
> left_join(df.x, df.y, by = "id")
  id name.x name.y
1  1      a      A
2  2      b      B
3  3      c   <NA>
> 
> # right join
> right_join(df.x, df.y, by = "id")
  id name.x name.y
1  1      a      A
2  2      b      B
3 30   <NA>      C


参考サイト


新しいPCはこんな感じです
マウスコンピュータのWindows PC(MB-B502E)