注目の投稿

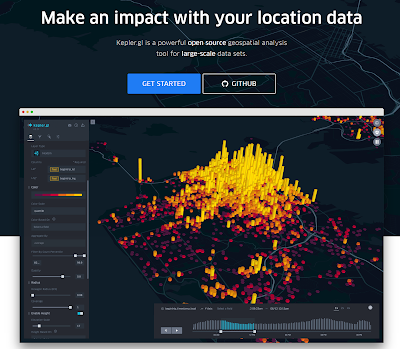
【kepler.gl】コロナ対策による人流の変化も地図上に可視化(各種メディアで報道)

kepler.glのサイト画面 kepler.glを使ってコロナ対策の効果を分析したところ、テレビ、新聞、ネットのメディアから問い合わせや報道依頼が殺到。今も、土日返上で都内や全国の人流変化を分析しています。この記事では人流変化の可視化に便利なkepler.glにつ...

ラベル SQL の投稿を表示しています。 すべての投稿を表示

2023年2月20日月曜日

【BigQuery 】緯度経度から50mメッシュコードを算出する方法

ぐぐっても出なかったので自分でSQL書きました。

ただ、未検証なのでご了承のほどよろしくお願いいたします。

BigQuery

WITH
  t0 AS (
  SELECT
    139.6917337 AS longitude,
    35.6895014 AS latitude ),
  t1 AS (
  SELECT
    latitude,
    longitude,
    /* FLOOR X 以下で最大の整数値を返します。*/ 
    /*round X のみが存在する場合、X を最も近い整数に丸めます。N が存在する場合、X を小数点以下の N 桁に丸めます。*/ 
    /*MOD(X, Y) Y による X の除算の剰余を返します。*/ 
    /* 1次メッシュ 辺の長さ:約80km 経度差:1度 緯度差:40分*/ 
    CONCAT( SAFE_CAST(SAFE_CAST(FLOOR(latitude*60/40) AS INT64) AS STRING), SAFE_CAST(SAFE_CAST(FLOOR(longitude)-100 AS INT64) AS STRING) ) AS mesh1d,
    /* 2次メッシュ 辺の長さ:約10km 経度差:7分30秒 緯度差:5分*/ 
    CONCAT( SAFE_CAST(SAFE_CAST(FLOOR(MOD(SAFE_CAST(ROUND(latitude*60, 7) AS NUMERIC), 40.0)/5) AS INT64) AS STRING), SAFE_CAST(SAFE_CAST(FLOOR(MOD(SAFE_CAST(longitude-100 AS NUMERIC), 1.0)*60/7.5) AS INT64) AS STRING) ) AS mesh2d,
    /*3次メッシュ 辺の長さ:約1km 経度差:45秒 緯度差:30秒 */ 
    CONCAT( SAFE_CAST(SAFE_CAST(FLOOR(MOD(MOD(SAFE_CAST(ROUND(latitude*60, 7) AS NUMERIC),40.0),5.0)* 60/30) AS INT64) AS STRING), SAFE_CAST(SAFE_CAST(FLOOR(MOD(MOD(SAFE_CAST(longitude AS NUMERIC),1.0)*60,7.5) * 60/45) AS INT64) AS STRING) ) AS mesh3d,
    /* 2分の1地域メッシュ 辺の長さ:約500m 経度差:22.5秒 緯度差:15秒 三次メッシュを緯線方向、経線方向に2等分してできる区域*/ 
    CONCAT( SAFE_CAST(SAFE_CAST(FLOOR(MOD(MOD(MOD(SAFE_CAST(ROUND(latitude*60, 7) AS NUMERIC),40.0),5.0),0.5)*4)*2+ FLOOR(MOD(MOD(MOD(SAFE_CAST((longitude-100) AS NUMERIC),1.0)*60,7.5),0.75)* 60/22.5)+1 AS INT64) AS STRING) ) AS mesh4d,
    /* 4分の1地域メッシュ 辺の長さ:約250m 経度差:11.25秒 緯度差:7.5秒 */ 
    CONCAT( SAFE_CAST(SAFE_CAST(FLOOR(MOD(MOD(MOD(MOD(SAFE_CAST(ROUND(latitude*60, 7) AS NUMERIC),40.0),5),0.5),0.25)*8)*2+ FLOOR(MOD(MOD(MOD(MOD(SAFE_CAST((longitude-100) AS NUMERIC),1)*60,7.5),0.75),0.375)*60/11.25)+1 AS INT64) AS STRING) ) AS mesh5d,
    /* 8分の1地域メッシュ 辺の長さ:約125m 経度差:5.625秒 緯度差:3.75秒 */
     CONCAT( SAFE_CAST(SAFE_CAST(FLOOR(MOD(MOD(MOD(MOD(MOD(SAFE_CAST(ROUND(latitude*60, 7) AS NUMERIC),40.0),5.0),0.5),0.25),0.125)*16)*2+ FLOOR(MOD(MOD(MOD(MOD(MOD(SAFE_CAST((longitude-100) AS NUMERIC),1)*60,7.5),0.75),0.375),0.1875)* 60/5.625)+1 AS INT64) AS STRING) ) AS mesh6d,
    /* 10分の1地域メッシュ 辺の長さ:約100m 経度差:4.5秒 緯度差:3秒 三次メッシュを緯線方向、経線方向に10等分してできる区域*/ 
    CONCAT( SAFE_CAST(SAFE_CAST(FLOOR(MOD(MOD(MOD(SAFE_CAST(ROUND(latitude*60, 7) AS NUMERIC),40.0),5.0),0.1)*20)*2+ FLOOR(MOD(MOD(MOD(SAFE_CAST((longitude-100) AS NUMERIC),1.0)*60,7.5),0.75)* 60/4.5)+1 AS INT64) AS STRING) ) AS mesh7d,
    /* 20分の1地域メッシュ 辺の長さ:約50m 経度差:2.25秒 緯度差:1.5秒 1/10メッシュを緯線方向、経線方向に2等分してできる区域*/ 
    CONCAT( SAFE_CAST(SAFE_CAST(FLOOR(MOD(MOD(MOD(MOD(SAFE_CAST(ROUND(latitude*60, 7) AS NUMERIC),40.0),5.0),0.1),0.05)*40)*2+ FLOOR(MOD(MOD(MOD(MOD(SAFE_CAST((longitude-100) AS NUMERIC),1.0)*60,7.5),0.75),0.075)* 60/2.25)+1 AS INT64) AS STRING) ) AS mesh8d
  FROM
    t0 )
SELECT
  latitude,
  longitude,
  CONCAT(mesh1d,mesh2d,mesh3d,mesh4d,mesh5d,mesh6d,mesh7d,mesh8d) AS mesh50m
FROM
  t1


参考


2020年5月1日金曜日

【BigQuery】特定の文字を含むものだけを集計する

フィールド「x」の先頭の文字が「Z」である場合に「y」の合計を集計するSQL
「LIKE」はあいまい検索、「%」はワイルドカードで「Z%」はZの後ろに何があってもよいことを示す。


SELECT
  SUM(CASE
      WHEN x LIKE "Z%" THEN y
  END
    ) AS total
FROM
  data


2020年4月19日日曜日

【BigQuery】1分毎に1レコード生成するクエリ

1分毎に1レコードを生成するクエリ。今回は、1分毎に北太平洋の任意の緯度経度を入れている。ケプラーで位置情報などを可視化する際に、複数のデータのグラフの高さを調整するために使うクエリ。1分毎でそのデータの最大値とならない場合は、1秒毎にしたり、同様のクエリを複数UNIONするなどで対応できる。

  SELECT
    DISTINCT FORMAT_DATETIME('%Y-%m-%d %H:%M',
      DATETIME(TIMESTAMP(time),
        'Asia/Tokyo') ) AS time_jpn,
    --北太平洋 31.036119, 165.169956
    31.036119 AS latitude,
    165.169956 AS longitude
  FROM
    table
  ORDER BY
    time_jpn


2020年4月6日月曜日

【BiqQuery】時間だけを取り出す

ビッククエリで時間だけを取り出すクエリはこちら
例えば、11:20だと11、06:30だと06を抽出する。

  SELECT
    userid,
    jpn_time,
    FORMAT_TIMESTAMP("%H", TIMESTAMP(jpn_time)) AS hour
  FROM
    table


2020年4月5日日曜日

【BigQuery】各ユーザが1週間にログインした日数を集計する方法

各ユーザが1週間に何日訪問したかを集計するクエリ。まず、各ユーザの日ごとの訪問日を集計し、1週間を週初めの日にち(月曜)に統一して週で何日訪問しているかを単純にカウントする。

  • クエリ例
WITH
  dau AS (
  SELECT
    date,
    userid
  FROM
    table
  GROUP BY
    date,
    userid)
SELECT
  DATE_ADD(date, INTERVAL - EXTRACT(DAYOFWEEK
    FROM
      DATE_ADD(date, INTERVAL -1 day)) +1 day) AS w_week,
  adid,
  COUNT(userid) AS vdays
FROM
  dau
GROUP BY
  w_week,
  userid
ORDER BY
  vdays DESC


2020年3月29日日曜日

【BigQuery】連続ログイン日数とその期間の最初と最後のログイン日を集計するクエリ

日次で連続してログインや訪問しているユーザの日数とその連続する期間の最初の日と最後の日を集計するクエリ。連続ログインが途切れて再度ログインした際は、別の期間として新たに集計。急いで書いたから読みにくい。。

◇クエリ例

WITH
  stays_table AS (
  SELECT
    *,
    CASE
      WHEN visit_date != DATE_ADD(lag_visit_date, INTERVAL 1 DAY) THEN 1
    ELSE
    0
  END
    AS not_continuous_flg
  FROM (
      --ユーザ毎の日付昇順での前回のデータを入れる項目の作成
    SELECT
      userid,
      visit_date,
      LAG(userid,1) OVER (PARTITION BY userid ORDER BY visit_date) AS lag_user_id,
      LAG(visit_date,1) OVER (PARTITION BY userid ORDER BY visit_date) AS lag_visit_date
    FROM (
      SELECT
        userid,
        DATE(TIMESTAMP(jpn_day)) AS visit_date
      FROM
        `data`
      GROUP BY
        userid,
        visit_date ) ) ),
  flg_cum AS(
  SELECT
    *,
    SUM(not_continuous_flg) OVER (PARTITION BY userid ORDER BY visit_date) AS cum_not_cont_date_flg
  FROM
    stays_table ),
  t1 AS (
  SELECT
    *,
    COUNT(cum_not_cont_date_flg) OVER (PARTITION BY userid, cum_not_cont_date_flg ORDER BY cum_not_cont_date_flg) AS cnt
  FROM
    flg_cum ),
  t00 AS (
    --00グループ:初回
  SELECT
    userid,
    not_continuous_flg,
    cum_not_cont_date_flg,
    MAX(cnt) AS stay_days,
    MIN(visit_date) AS first_loginday
  FROM
    t1
  WHERE
    t1.not_continuous_flg = 0
    AND t1.cum_not_cont_date_flg = 0
  GROUP BY
    userid,
    not_continuous_flg,
    cum_not_cont_date_flg,
    cnt
  ORDER BY
    userid ),
  t11 AS (
    --1と1以上グループ:2回目以降
  SELECT
    userid,
    not_continuous_flg,
    cum_not_cont_date_flg,
    MAX(cnt) AS stay_days,
    MIN(visit_date) AS first_loginday
  FROM
    t1
  WHERE
    t1.not_continuous_flg = 1
    AND t1.cum_not_cont_date_flg > 0
  GROUP BY
    userid,
    not_continuous_flg,
    cum_not_cont_date_flg,
    cnt
  ORDER BY
    userid,
    not_continuous_flg,
    cum_not_cont_date_flg ),
  x1 AS (
  SELECT
    userid,
    cum_not_cont_date_flg,
    stay_days,
    first_loginday
  FROM
    t00
  UNION ALL
  SELECT
    userid,
    cum_not_cont_date_flg,
    stay_days,
    first_loginday
  FROM
    t11 ),
  x2 AS (
  SELECT
    userid,
    cum_not_cont_date_flg,
    stay_days,
    first_loginday
  FROM
    x1
  GROUP BY
    userid,
    cum_not_cont_date_flg,
    stay_days,
    first_loginday
  ORDER BY
    userid,
    cum_not_cont_date_flg,
    stay_days,
    first_loginday )
SELECT
  userid,
  cum_not_cont_date_flg,
  stay_days,
  first_loginday,
  DATE_ADD(first_loginday, INTERVAL stay_days - 1 DAY) AS last_loginday
FROM
  x2

◇参考サイト


2020年1月5日日曜日

【トレジャーデータ:presto】任意の値や文字列を入れた列をつくる方法

入れたい値 AS 新しい列名
とすることで任意の値を入れた列を作ることができる。


  • 数字の場合

SELECT
1 AS x
FROM data_table


  • 文字列の場合

SELECT
'なにか' AS x
FROM data_table


2017年2月21日火曜日

【トレジャーデータ:Treasure Workflow】今注目のTreasure Workflowとは?その導入手順と活用例(SQL文ループ処理)の紹介

TD Workflowとは?

簡単に言うとTDで実行するクエリをメタなレベルで処理するための機能。例えば、複数のクエリを任意の順序で実行したいときやクエリのループ処理をしたいとき等に使える。

導入手順

  1. コンソールを起動(windowsだとコマンドプロンプト)
  2. 自分のTDアカウントにログインする
  3. TDをアップデートする(td update)
  4. TD Workflowをインストール(td workflow)

ループ処理の方法


1.クエリ操作するファイル(dig)とクエリを格納するフォルダを作成(必要に応じて)


td_testというフォルダ下に、クエリを保管するフォルダとdigファイルを作成している

2.クエリを作成

sample.sql
SELECT 
  TD_TIME_FORMAT(time,
    'yyyy-MM-dd',
    'jst') AS time_date,
  AVG(CLOSE) AS daily_avg_close
FROM
  #TDにサンプルで入っているナスダックのデータ
  sample_datasets.nasdaq
WHERE
  #datetime_fromとdatetime_toはdigファイルで定義
  TD_TIME_RANGE(time,
    '${datetime_from}',
    '${datetime_to}',
    'JST')
GROUP BY
  TD_TIME_FORMAT(time,
    'yyyy-MM-dd',
    'jst')

3.digファイルを作成

sample.dig
_export:
  basetime: "2011-03-01 00:00:00"
  loopcount: 5
  td:
    database: workflow_temp

+loop:
  loop>: ${loopcount}
  _do:
    +step:
      _export:
        datetime_from: ${moment(basetime, "YYYY-MM-DD HH:mm:ss").
         add(i, "days").format("YYYY-MM-DD HH:mm:ss")}
        datetime_to: ${moment(basetime, "YYYY-MM-DD HH:mm:ss").
         add(1 + i, "days").format("YYYY-MM-DD HH:mm:ss")}
      td>: queries/sample.sql
      insert_into: roop_test

4.コンソールで実行(事前にdigファイルがあるディレクトリに移動しておく)

 td wf run sample
で実行


実行中の画面

5.結果

 しっかりデータが入っている


1ループ1日分の処理が5回されるため5日分のデータがテーブルに入る


◇参考サイト(一部、TDのアカウントが無いと見れないかも)


2017年2月15日水曜日

【トレジャーデータ:Presto】ユーザの継続利用状況を可視化するⅠ(アクセス日数遷移)

◇継続利用可視化の重要性


ゲーム、メディア、ECサイト等を運営する上で重要なデータの一つがユーザの継続利用状況。この継続利用状況を可視化することで見えてくる課題は多い。例えば、継続利用の数値が悪ければ、新規獲得コストが高いこと、競合への乗り換えリスクが高いこと、サービスを長期に支えてくれるヘビーユーザ層が少ないこと、長期安定運営が困難なこと等々の課題がある可能性が高い。
 
以前、ゲーム買収の評価分析をしていた際、最も重要としていたのがユーザの継続利用のデータ。実際、この数値が悪ければポジティブな評価をすることはなかった。理由は、1.新規を獲得しても直ぐに離脱するためコストに対するリターンが少ない、2.増え続ける競合に乗り換えるユーザも日に日に増えていくため離脱に対する新規獲得が早い段階で追いつかなくなる、3.1と2よりビジネス的にサービスを長期的に継続することが困難であるからだ。そのため、買収評価の際は、利用状況によってユーザの継続率を予想するモデルを構築し、買収後2年先までの売上を維持するために最低限必要な月間の新規獲得UUをシミュレーションによって厳密に推定していた。
 
ただ、日々の継続利用を把握するために毎日モデルを構築してシミュレーションすることは現実的ではない。そこで、一度のクエリ構築で自動で現状把握できる分析が求められる。この分析の一つが、アクセス日数遷移。これは、各ユーザの当週(集計日から遡って7日間)と前週(当週に対する前週)のアクセス日数の変化を見ることで、ユーザの継続利用状況を可視化できる。また、前週と前々週の結果も合わせて比較することで、施策実施前後の数値から施策の効果を確認することもできる。


◇アクセス日数遷移の集計イメージ(上部が比率、下部がUU)


*数値は仮想のもの
最新↓当週
前週→last_week離脱率this_1this_2this_3this_4this_5this_6this_7
193%3%3%1%0%0%0%0%
288%9%2%1%0%0%0%0%
363%23%10%2%0%1%0%0%
431%32%20%9%7%1%1%0%
514%28%26%2%15%11%3%2%
60%22%24%10%10%14%19%2%
714%8%5%33%16%8%13%4%
当週新規0%72%25%2%0%0%0%0%
UU前週合計
last_weekthis_no_accessthis_1this_2this_3this_4this_5this_6this_7918
1700222271000752
213014310000148
36210000010
4221100007
5000000001
6000000001
7000000000
当週新規02508881000347
当週合計838291115173100427


◇クエリ例(上の集計イメージ下部のUUを集計する部分。比率は別途計算)


--アクセス日数遷移
--集計日から遡って7日間の内にアクセスした日数を集計
WITH sq_this_week AS(
  SELECT
    user_id,
    COUNT(DISTINCT TD_TIME_FORMAT(TIMESTAMP,
        'yyyy-MM-dd',
        'jst')) AS this_days
  FROM
    access_log
  WHERE
    TD_TIME_RANGE(TIMESTAMP,
      TD_TIME_ADD(TD_SCHEDULED_TIME(),
        '-7d'),
      TD_SCHEDULED_TIME(),
      'jst')
  GROUP BY
    user_id
),
sq_last_week AS(
  SELECT
    user_id,
    COUNT(DISTINCT TD_TIME_FORMAT(TIMESTAMP,
        'yyyy-MM-dd',
        'jst')) AS last_days
  FROM
    access_log
  WHERE
    TD_TIME_RANGE(TIMESTAMP,
      TD_TIME_ADD(TD_SCHEDULED_TIME(),
        '-14d'),
      TD_TIME_ADD(TD_SCHEDULED_TIME(),
        '-7d'),
      'jst')
  GROUP BY
    user_id
),
sq_days AS(
  SELECT
    sq_last_week.user_id AS last_user_id,
    sq_this_week.user_id AS this_user_id,
    -- nullであれば0とする
    COALESCE(
      sq_last_week.last_days,
      0
    ) AS last_days,
    COALESCE(
      sq_this_week.this_days,
      0
    ) AS this_days
  FROM (sq_last_week) FULL
  JOIN (sq_this_week)
    ON (
      sq_last_week.user_id = sq_this_week.user_id
    )
),
sq_uu AS(
  SELECT
    last_days,
    this_days,
    COUNT(DISTINCT CASE WHEN last_days > 0 THEN last_user_id WHEN this_days > 0 THEN this_user_id END) AS uu
  FROM
    sq_days
  GROUP BY
    last_days,
    this_days
) SELECT
  last_days,
  COALESCE(
    SUM(CASE
        WHEN this_days = 0 THEN uu END),
    0
  ) AS "0",
  COALESCE(
    SUM(CASE
        WHEN this_days = 1 THEN uu END),
    0
  ) AS "1",
  COALESCE(
    SUM(CASE
        WHEN this_days = 2 THEN uu END),
    0
  ) AS "2",
  COALESCE(
    SUM(CASE
        WHEN this_days = 3 THEN uu END),
    0
  ) AS "3",
  COALESCE(
    SUM(CASE
        WHEN this_days = 4 THEN uu END),
    0
  ) AS "4",
  COALESCE(
    SUM(CASE
        WHEN this_days = 5 THEN uu END),
    0
  ) AS "5",
  COALESCE(
    SUM(CASE
        WHEN this_days = 6 THEN uu END),
    0
  ) AS "6",
  COALESCE(
    SUM(CASE
        WHEN this_days = 7 THEN uu END),
    0
  ) AS "7"
FROM
  sq_uu
GROUP BY
  last_days
ORDER BY
  last_days


◇ネクストステップ


2017年1月23日月曜日

【SQL:PRESTO】完全自分用

ユーザ毎の閲覧順序・間隔やカテゴリページ毎の閲覧順序・UUを集計

事前にユーザ別のアクセスカテゴリページと期間内初アクセス日を集計したテーブルを構築

--閲覧間隔日数を出す場合は適時クエリを修正
WITH sq_sort_now AS(
  SELECT
    tracking_data,
    node,
    min_accesstime
    --テーブル名変更
  FROM
    mezzo_min_access_time
  ORDER BY
    min_accesstime,
    tracking_data
),
sq_sort_next AS(
  SELECT
    tracking_data,
    node,
    min_accesstime
    --テーブル名変更
  FROM
    mezzo_min_access_time
),
sq_order AS(
  SELECT
    sq_sort_now.tracking_data,
    sq_sort_now.node AS now_node,
    sq_sort_now.min_accesstime AS now_accesstime,
    sq_sort_next.node AS next_node,
    sq_sort_next.min_accesstime AS next_accesstime
  FROM (sq_sort_now)
  JOIN
    (sq_sort_next)
    ON (
      sq_sort_now.tracking_data = sq_sort_next.tracking_data
      AND sq_sort_now.node != sq_sort_next.node
    )
  ORDER BY
    sq_sort_now.tracking_data
),
sq_order_diff AS(
  SELECT
    tracking_data,
    now_node,
    now_accesstime,
    next_node,
    next_accesstime,
    date_diff(
      'day',
      -- 他にも minute, hour, week, monthなども指定できる
      CAST(
        now_accesstime AS TIMESTAMP
      ),
      CAST(
        next_accesstime AS TIMESTAMP
      )
    ) AS time_diff
  FROM
    sq_order
  WHERE
    date_diff(
      'day',
      -- 他にも minute, hour, week, monthなども指定できる
      CAST(
        now_accesstime AS TIMESTAMP
      ),
      CAST(
        next_accesstime AS TIMESTAMP
      )
    )>= 0
  ORDER BY
    tracking_data
),
sq_uu AS(
--閲覧間隔日数を含むデータ
--ここのデータを出したい場合は本クエリを最終結果とする
  SELECT
    now_node,
    next_node,
    time_diff,
    COUNT(DISTINCT tracking_data) AS uu
  FROM (sq_order_diff)
  GROUP BY
    now_node,
    next_node,
    time_diff
  ORDER BY
    now_node,
    next_node,
    time_diff
)
--順序のみ出す ネットワーク作図用データ
SELECT
  now_node,
  next_node,
  sum(uu) sum_uu
FROM
  sq_uu
WHERE
 uu > 10
GROUP BY
  now_node,
  next_node
ORDER BY
  now_node,
  next_node

2016年12月1日木曜日

【SQL】カンマ区切りの文字列を複数行に分割して取得する(presto:SQL)

 aaa, bbb, ccc を
 aaa
 bbb
 ccc
にするには下記の方法がある

select
  split_record
from
  tbl_test t1
cross join unnest( --・・・(1)
  split(t1.csv_column, ',') --・・・(2)
) as t (split_records)


◇参照サイト
 cross join unnestを利用して、カンマ区切りのデータを単一の列の複数レコードに分解する。
http://qiita.com/ymd_shy/items/80aebf3956d48fb509a6

2016年11月16日水曜日

【トレジャーデータ】データベース名が数字の場合(sql:presto)

データベース名の先頭が数字の場合通常ならエラーとなるが、""でDB名を囲むことでエラー回避できる。

例

      FROM
        "1_db". tb

2016年10月27日木曜日

【トレジャーデータ】記事別DAU階級推移(SQL:case文を使う)

 閲覧記事のDAUの構造的変化を把握したいときは、各記事をDAU階級*に分けてその変化を見る方法があります。

*DAU階級例
階級UU数(dau)
A10001~
B5001~10000
C1001~5000
D101~1000
E1~100


階級分けはkmeans等を使う場合が多いですが、複数のPJやメディア等を横串で評価する場合は定性評価で統一基準を設けても良いです(と思っています)。

実際には、下記のような集計をおこない階級別の推移を見て、施策の効果や現状の課題等を把握します。

date_timeA_dauB_dauC_dauD_dauE_dau
2016-10-20?????
2016-10-21?????
2016-10-22?????
2016-10-23?????
2016-10-24?????
2016-10-25?????
2016-10-26?????

具体的なSQLの例は下記となります。

データ名:data(すでに各記事のdauを集計済)
データ構造:date_time(yyyy-MM-dd), page_name(記事の名前), dau
補足:集計は度数分布表やヒストグラム作成に用いるcase文を利用

SELECT
date_time,
SUM(CASE
    WHEN dau >= 10001 THEN dau END) AS A_dau,
SUM(CASE
    WHEN dau >= 5001 AND dau < 10000 THEN dau END) AS B_dau,
SUM(CASE
    WHEN dau >= 1001 AND dau < 5000 THEN dau END) AS C_dau,
SUM(CASE
    WHEN dau >= 101 AND dau < 1000 THEN dau END) AS D_dau,
SUM(CASE
    WHEN dau >= 1 AND dau < 100 THEN dau END) AS E_dau
FROM
data
WHERE
--自動集計するためのコード
TD_TIME_RANGE(TD_TIME_PARSE(date_time),
              TD_TIME_ADD(TD_SCHEDULED_TIME(),
                          '-7d'), --7日分のデータを集計
              TD_SCHEDULED_TIME(),
              'jst')
GROUP BY
date_time
ORDER BY
date_time

今回は各記事のDAUを集計していますが、
THEN dau END → THEN 1 else 0 END
とすることで階級別の記事数を集計できます。